Image Compression
Overview
熵编码
熵编码或统计编码属于无损编码,给出现概率较大的符号赋予一个短码字,给出现概率较小的符号赋予一个长码字,从而使最终的平均码长很小。主要的熵编码方法包括哈夫曼编码、香农编码、算术编码等。
哈夫曼编码
扫描各种颜色的像素出现的概率,然后按照概率大小组成哈夫曼编码。(个人感觉意义不大)
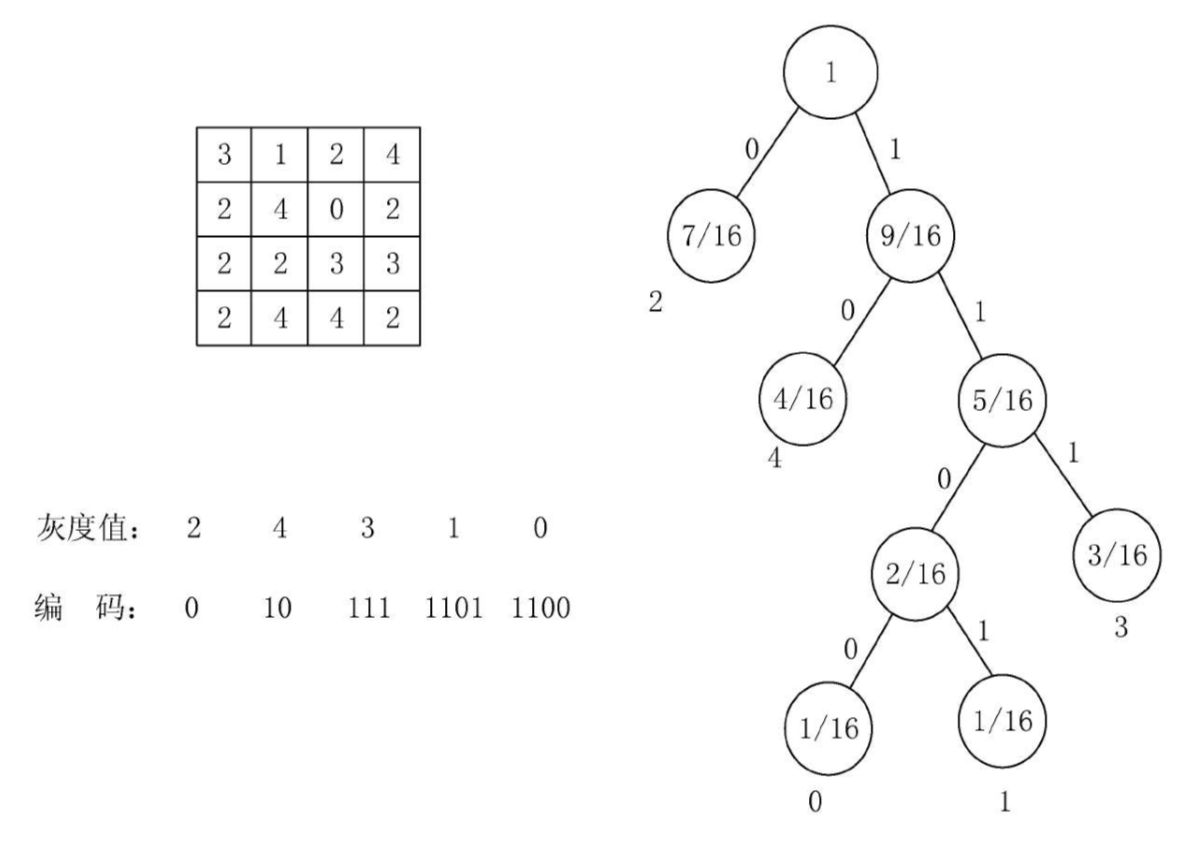
Demo(他给的代码其实有问题)
2
4 1
0 011
1 010
3 00
import numpy as np
import queue
"""
定义需要进行编码的图像
"""
image = np.array(
    [
        [3,1,2,4],
        [2,4,0,2],
        [2,2,3,3],
        [2,4,4,2]
    ]
)
"""
计算每种元素出现的概率
"""
hist = np.bincount(image.ravel(), minlength=5)
probabilities = hist / np.sum(hist)
"""
找出数据中的最小元素
"""
def get2smallest(data):
    first = second = 1;
    fid = sid = 0
    for idx, element in enumerate(data):
        if (element < first):
            second = first
            sid = fid
            first = element
            fid = idx
        elif (element < second and element != first):
            second = element
    return fid, first, sid, second
""""
定义哈夫曼树节点
"""
class Node:
    def __init__(self):
        self.prob = None
        self.code = None
        self.data = None
        self.left = None
        self.right = None      # 元素值存储在叶节点
    def __lt__(self, other):
        if (self.prob < other.prob):  # 定义优先树中排序规则
            return 1
        else:
            return 0
    def __ge__(self, other):
        if (self.prob > other.prob):
            return 1
        else:
            return 0
"""
构建哈夫曼树
"""
def tree(probabilities):
    prq = queue.PriorityQueue()
    for color, probability in enumerate(probabilities):
        leaf = Node()
        leaf.data = color
        leaf.prob = probability
        prq.put(leaf)
    while (prq.qsize() > 1):
        newnode = Node()    #  创建新节点
        l = prq.get()
        r = prq.get()    #  找出叶节点中概率最小的两个
        # 移除最小的两个节点
        newnode.left = l    # 左侧是较小的
        newnode.right = r
        newprob = l.prob + r.prob   # 新的概率是两个小概率相加
        newnode.prob = newprob
        prq.put(newnode)    #  插入新节点,替代原有的两个节点
    return prq.get()     # 返回根节点,完成树的构建
"""
对哈夫曼树进行遍历,得出编码
"""
def huffman_traversal(root_node, tmp_array, f):
    if (root_node.left is not None):
        tmp_array[huffman_traversal.count] = 1
        huffman_traversal.count += 1
        huffman_traversal(root_node.left, tmp_array, f)
        huffman_traversal.count -= 1
    if (root_node.right is not None):
        tmp_array[huffman_traversal.count] = 0
        huffman_traversal.count += 1
        huffman_traversal(root_node.right, tmp_array, f)
        huffman_traversal.count -= 1
    else:
        huffman_traversal.output_bits[
            root_node.data] = huffman_traversal.count  # 得出每个元素的编码值
        bitstream = ''.join(str(cell) for cell in tmp_array [1:huffman_traversal.count])
        color = str(root_node.data)
        wr_str = color + ' ' + bitstream + '\n'
        f.write(wr_str)  #  保存到文件中
    return
root_node = tree(probabilities)
tmp_array = np.ones([4], dtype=int)
huffman_traversal.output_bits = np.empty(5, dtype=int)
huffman_traversal.count = 0
f = open('codes.txt', 'w')
huffman_traversal(root_node, tmp_array, f)  # 遍历树结构,给出编码
算术编码
个人觉得也意义不大,跳过吧
解释
算术编码的算法思想如下。
- 对一组信源符号按照符号的概率从大到小排序,将[0,1)设为当前分析区间。按信源符号的概率序列在当前分析区间划分比例间隔。
- 检索“输入消息序列”,锁定当前消息符号(初次检索的话就是第一个消息符号)。找到当前符号在当前分析区间的比例间隔,将此间隔作为新的当前分析区间,并把当前分析区间的起点(即左端点)指示的数“补加”到编码输出数里。当前消息符号指针后移。
- 仍然按照信源符号的概率序列在当前分析区间划分比例间隔。然后重复第二步,直到“输入消息序列”检索完毕为止。
- 最后的编码输出数就是编码好的数据。
在算术编码中需要注意3个问题。
- 由于实际计算机的精度不可能无限长,运算中出现溢出是一个明显的问题,但多数计算机都有16位,32位或者64位的精度,因此这个问题可以使用比例缩放方法解决。
- 算术编码器对整个消息只产生一个码字,这个码字是在间隔[0,1)中的一个实数,因此译码器在接收到表示这个实数的所有位之前不能进行译码。
- 算术编码是一种对错误很敏感的编码方法,如果有一位发生错误,就会导致整个消息译错。
算术编码可以是静态的或者是自适应的。在静态算术编码中,信源符号的概率是固定的。在自适应算术编码中,信源符号的概率根据编码时符号出现的频率动态地修改,在编码期间估算信源符号概率的过程叫作建模。需要开发动态算术编码的原因是事前知道精确的信源概率是很难的,而且不切实际。当压缩消息时,不能期待一个算术编码器获得最大的效率,所能做的最有效的方法是在编码过程中估算概率。因此,动态建模就成为确定编码器压缩效率的关键。
RLE编码
比较简单,也可以略
行程长度编码(Run- Length Encoding,RLE)压缩算法是Windows系统中使用的一种图像文件压缩方法
例如:RRRRRGGBBBBBB -> 5R2G6B
LZW编码
wiki[1], 各种版本的 LZW 实现[2], geeksforgeeks[3]
- 数据流(CharStream):对象(文本文件的数据序列)
- 编码流(CodeStream):输出对象(经过压缩运算的编码数据)
- 编译表(String Table):编译表不是事先创建好的,而是根据原始文件数据动态创建的
- LZW压缩算法的基本原理:提取原始文本文件数据中的不同字符,基于这些字符创建一个编译表,然后用编译表中的字符的索引替代原始文本文件数据中的相应字符,减少原始数据大小。
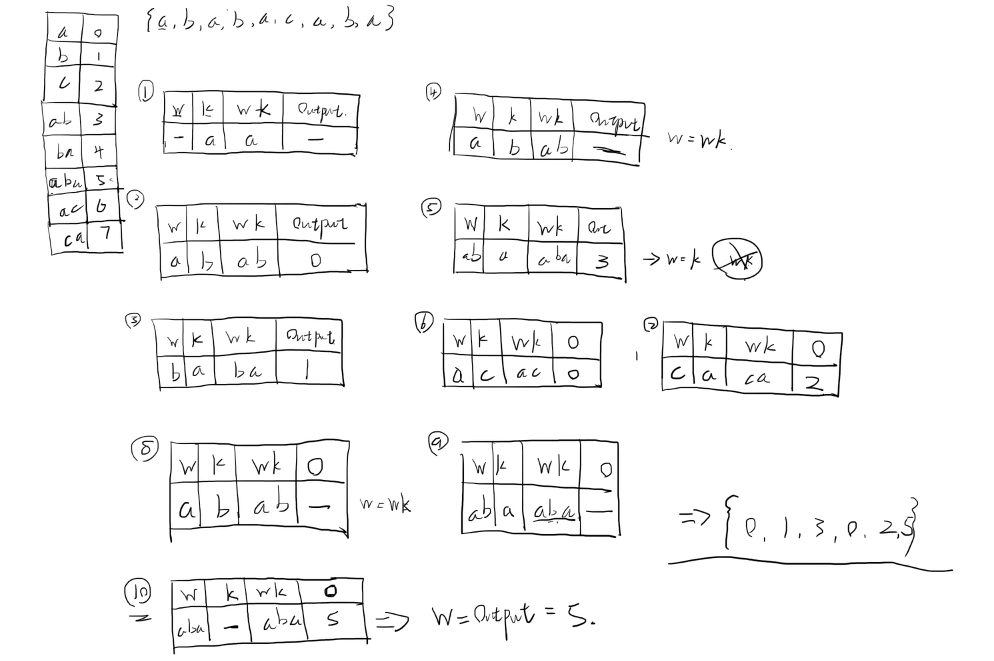
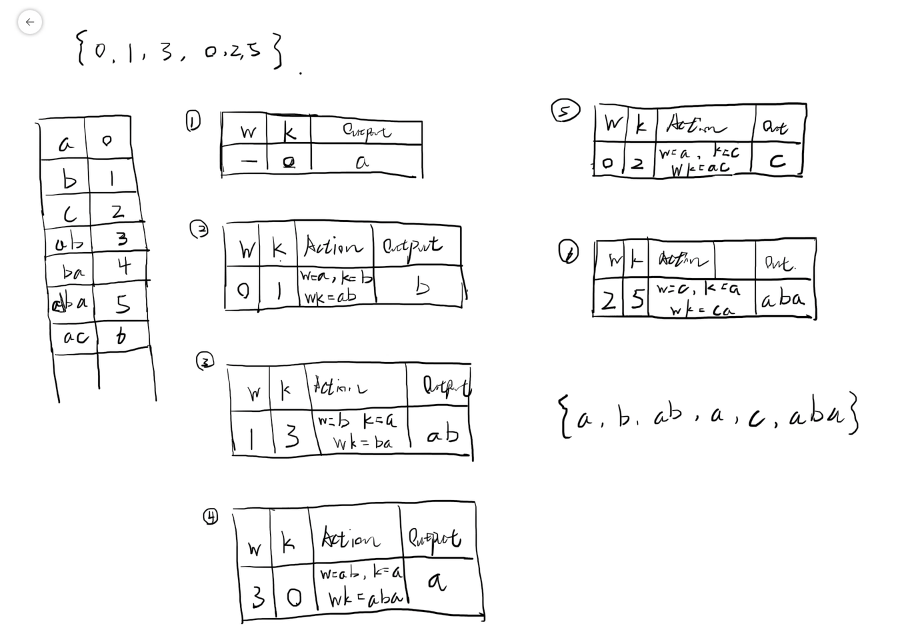
详细过程感觉并不好记,使用时随时翻阅资料吧
预测编码
基于图像数据的空间或时间冗余特性,用相邻的已知像素(或像素块)预测当前像素(或像素块)的取值,然后再对预测误差进行量化和编码,包括脉冲编码调制(PCM)、差分脉冲编码调制(DPCM)等。
DM 编码
- wiki[6]:https://en.wikipedia.org/wiki/Delta_modulation
- 精髓是用变换来保存序列。
- 做法是用上行和下行两种信号模拟一个连续信号,把连续信号转换成离散。
- 需要用过采样,即以比奈奎斯特速率高几倍的速率对模拟信号采样。
- DM 是 DPCM 的最简单形式。
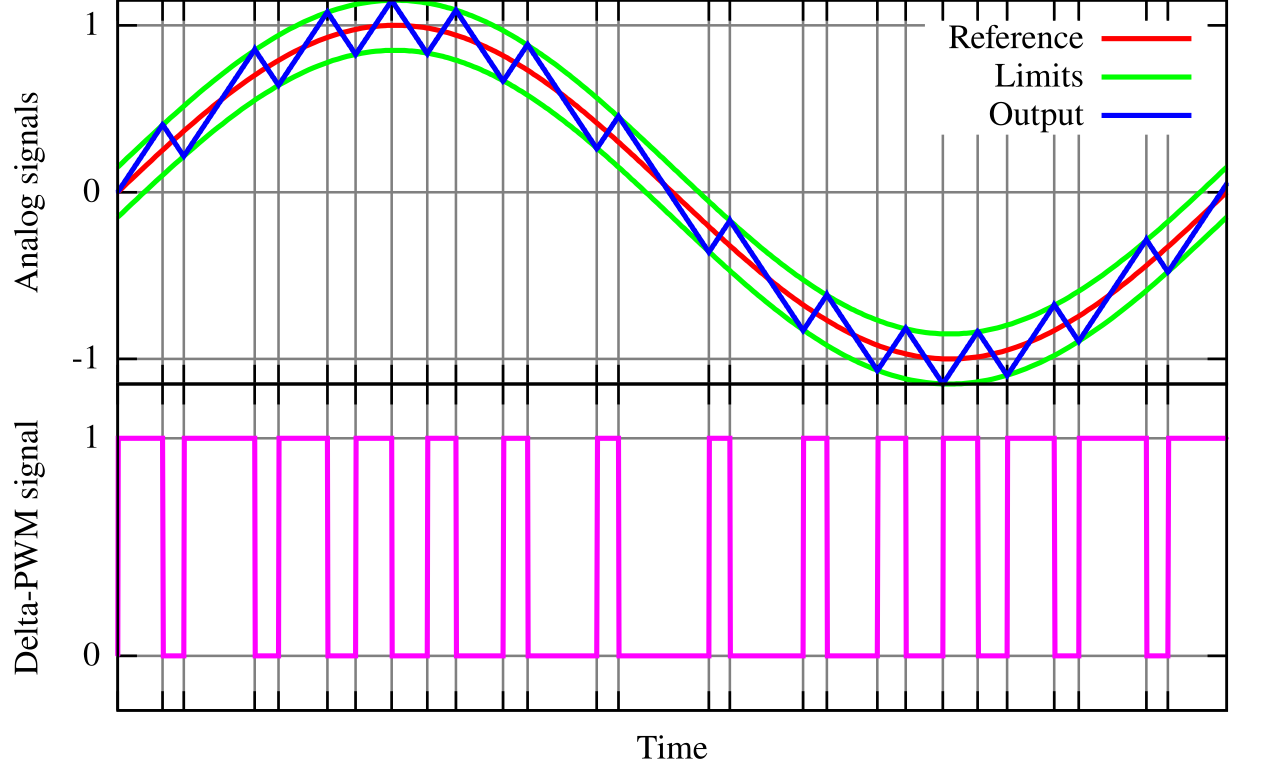
Demo
比如对[33, 35, 34, 36, 35]进行编码,步长为 4.5
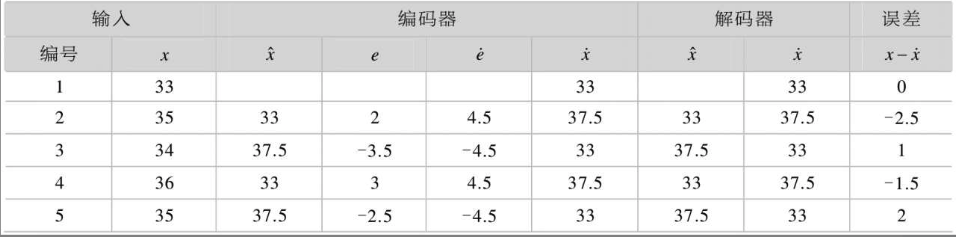
结果就是[33, 1, 0, 1, 0],其中 33 代表初始的位置,1 代表上升,0 代表下降。
DPCM 编码
- wiki[7]:https://en.wikipedia.org/wiki/Differential_pulse-code_modulation
- 精髓也是用变化代替绝对值。
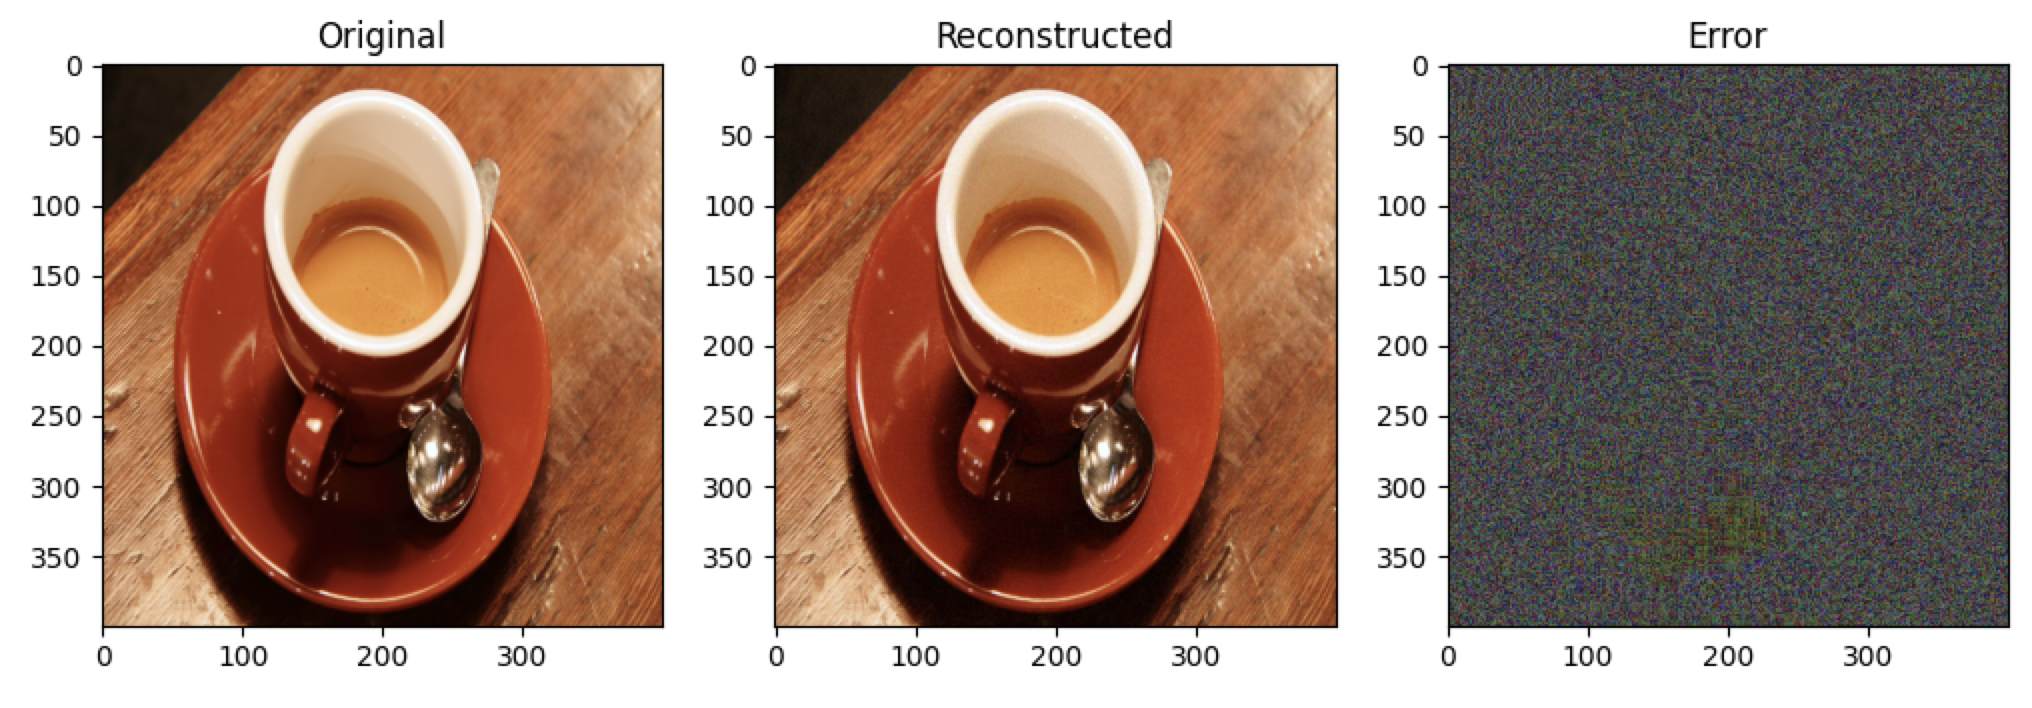
- 这个变化是用某个像素的一边(下例是 左,左上,上三个方向)来预测这个像素。然后用预测值与本像素相减,得到误差。
- 这个误差会经过量化,这一步引入了误差,也达到了压缩的目的。
Demo
import numpy as np
from skimage import data
from skimage import transform
from matplotlib import pyplot as plt

def quantize_error(error,level):
    max=255
    min=-255
    q=(max-min)/level
    i=1
    while(error>=min+q*i):
        i=i+1
    quantized_error=min+q*(i-1)+q/2
    return  quantized_error

def DPCM_encoder(img,level):
    N=img.shape[0]
    predictor=np.zeros(shape=(N,N))
    quantized_error=np.zeros(shape=(N,N))
    for i in range(N):
        for j in range(N):
            if i==0:
                if j==0:
                    predicted=0
                else:
                    predicted=0.95*predictor[i,j-1]
            else:predicted=0.95*predictor[i-1,j]+0.95*predictor[i,j-1]-0.95**2*predictor[i-1,j-1]
            error=img[i,j]-predicted
            quantized_error[i,j]=quantize_error(error,level)
            predictor[i,j]=predicted+quantized_error[i,j]
        for j in range(i,N):
            if i==0:
                predicted = 0.95 * predictor[j - 1, i]
            else:predicted=0.95*predictor[j-1,i]+0.95*predictor[j,i-1]-0.95**2*predictor[j-1,i-1]
            error=img[j,i]-predicted
            quantized_error[j,i]=quantize_error(error,level)
            predictor[j,i]=predicted+quantized_error[j,i]
    return quantized_error

def DPCM_decoder(error):
    N=error.shape[0]
    img=np.zeros(shape=(N,N))
    predictor=np.zeros(shape=(N,N))
    for i in range(N):
        for j in range(N):
            if i==0:
                if j==0:
                    predicted=0
                else:
                    predicted=0.95*predictor[i,j-1]
            else:
             predicted=0.95*predictor[i-1,j]+0.95*predictor[i,j-1]-0.95**2*predictor[i-1,j-1]
            img[i,j]=predicted+error[i,j]
            predictor[i,j]=predicted+error[i,j]
    return img

if __name__ == '__main__':
    levels=32
    img=data.coffee()
    img=transform.resize(img,(img.shape[0],img.shape[0],3), preserve_range=True)
    plt.subplot(1,3,1)
    plt.title("Original")
    plt.imshow(img/255.0)
    img_r=img[:,:,0]
    encoded_img_r=DPCM_encoder(img_r,levels)
    decoded_img_r=DPCM_decoder(encoded_img_r)
    decoded_img_r=decoded_img_r.reshape((decoded_img_r.shape[0], decoded_img_r.shape[1],1))
    img_g = img[:, :, 1]
    encoded_img_g = DPCM_encoder(img_g, levels)
    decoded_img_g = DPCM_decoder(encoded_img_g)
    decoded_img_g = decoded_img_g.reshape((decoded_img_g.shape[0],decoded_img_g.shape[1],1))
    img_b = img[:, :, 2]
    encoded_img_b = DPCM_encoder(img_b, levels)
    decoded_img_b = DPCM_decoder(encoded_img_b)
    decoded_img_b = decoded_img_b.reshape((decoded_img_b. shape[0],decoded_img_b.shape[1],1))
    decoded_img=np.concatenate([decoded_img_r,decoded_img_g, decoded_img_b],2)

    plt.subplot(1,3,2)
    plt.title("Reconstructed")
    plt.imshow(decoded_img/255.0)
    plt.subplot(1,3,3)
    plt.title("Error")
    error = np.abs((img-decoded_img))
    error/=np.max(error)
    plt.imshow(error*4,vmin=0, vmax=1)
    plt.show()
变换编码
将空域上的图像变换到另一变换域上,变换后图像的大部分能量只集中到少数几个变换系数上,采用适当的量化和熵编码就可以有效地压缩图像。
典型的准最佳变换有DCT(离散余弦变换)、DFT(离散傅里叶变换)、WHT(Walsh Hadama变换)、HrT(Haar变换)等。
K-L 变换
- K-L 变换又称 Hotelling 变换,特征向量变换或主分量方法(这个就是主成分分析法吧。。)
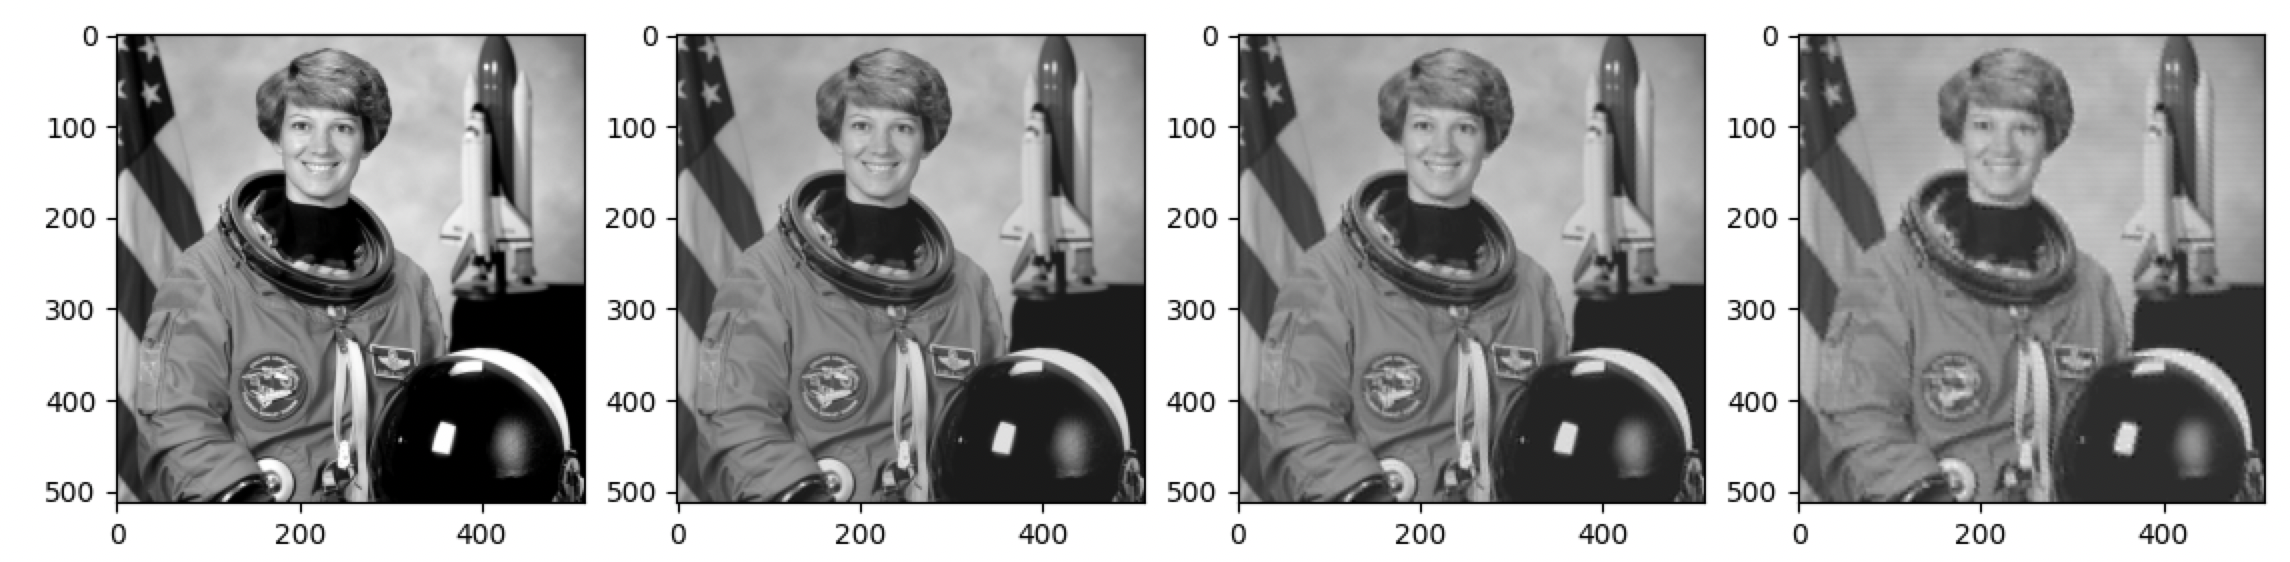
步骤1:读取图片,将图片信息以8x8图像方块合成一个向量,将整张图片分割成一个n*64的矩阵A。
步骤2:计算向量数据矩阵A的协方差矩阵(64x64)。
步骤3:对协方差矩阵进行特征分解,并按特征值大小排列特征向量D。
步骤4:计算AD,得到kl变换矩阵K。
步骤5:将矩阵K的后m列置为0。
步骤6:通过K*D^T得新矩阵A,并将其重新还原图像。
Demo[8]
import cv2
import numpy as np
import matplotlib.pyplot as plt
import skimage.data as data

def img2vec(image, blocksize):
    image_w, image_h = img.shape
    # 图像方块数据转换为向量
    img_block_vec = np.zeros((int(image_w*image_h/blocksize/blocksize), blocksize*blocksize))
    i = 0
    for r in range(0,image.shape[0], blocksize):
        for c in range(0,image.shape[1], blocksize):
            block = image[r:r+blocksize,c:c+blocksize]
            block = np.resize(block, (1, blocksize*blocksize))
            img_block_vec[i] = block
            i += 1
    return img_block_vec

def vec2img(vectors, blocksize):
    # 向量数据转换为图像
    img_kl = np.zeros((new_w, new_h))
    i = 0
    for r in range(0,img_kl.shape[0], blocksize):
        for c in range(0,img_kl.shape[1], blocksize):
            block = vectors[i]
            block = np.resize(block, (blocksize, blocksize))
            i += 1
            img_kl[r:r+blocksize,c:c+blocksize] = block
    return img_kl.astype(int)

def kl_transform(vectors, principal_n):
    # 计算协方差矩阵和特征
    cov_matrix = np.cov(vectors.T)
    _, fvec = np.linalg.eig(cov_matrix)    # 输出的特征值默认降序排列
    img_kl_block_vec = np.dot(vectors, fvec)
    # 压缩,将非前N个主成分置为0
    img_kl_block_vec[:,principal_n:] = 0
    return np.dot(img_kl_block_vec, fvec.T)


if __name__ == "__main__":
    # filename = '3.png'
    blocksize = 8           # 像素块
    principal_n1 = 16       # 贡献度高的前N个特征值个数
    principal_n2 = 8       # 贡献度高的前N个特征值个数
    principal_n3 = 4       # 贡献度高的前N个特征值个数

    # 读取图片
    # img = cv2.imread(filename)
    img = data.astronaut()
    # img = np.array(cv2.cvtColor(img, cv2.COLOR_BGR2GRAY))   #灰度化处理
    img = np.array(cv2.cvtColor(img, cv2.COLOR_RGB2GRAY))   #灰度化处理

    # 图像大小设置为blocksize倍数
    image_w, image_h = img.shape
    new_w, new_h = image_w//blocksize*blocksize, image_h//blocksize*blocksize
    img = cv2.resize(img, (new_h, new_w))
    vec = img2vec(img, blocksize)
    kl1 = vec2img(kl_transform(vec, principal_n1), blocksize)
    kl2 = vec2img(kl_transform(vec, principal_n2), blocksize)
    kl3 = vec2img(kl_transform(vec, principal_n3), blocksize)

    plt.subplot(1, 4, 1)
    plt.imshow(img, 'gray')
    plt.subplot(1, 4, 2)
    plt.imshow(kl1, 'gray')
    plt.subplot(1, 4, 3)
    plt.imshow(kl2, 'gray')
    plt.subplot(1, 4, 4)
    plt.imshow(kl3, 'gray')
    plt.show()
DCT 变换
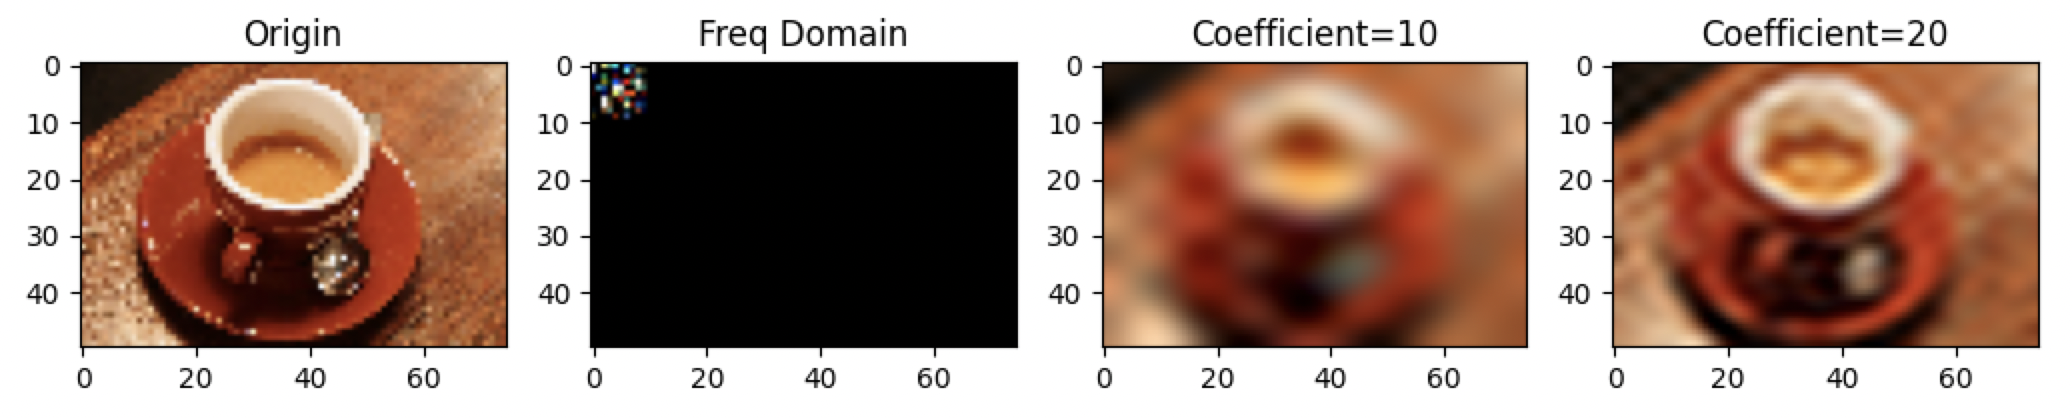
发送者首先将输入图像分解为8×8或16×16的块,然后再对每个图像块进行二维DCT,接着对DCT系数进行量化、编码和传输。
接收者通过对量化的DCT系数进行解码,并对每个图像块进行二维DCT逆变换。
最后将操作完成后所有的块拼接起来构成一幅单一的图像。
对于一般的图像而言,大多数DCT系数值都接近0,所以去掉这些系数不会对重建图像的质量产生较大的影响。因此,利用DCT进行图像压缩确实可以节约大量的存储空间。
DCT:
iDCT:
Demo
from math import cos, pi, sqrt
import numpy as np
from skimage import data
from matplotlib import pyplot as plt
def dct_2d(image, numberCoefficients=0):
    nc = numberCoefficients
    height = image.shape[0]
    width = image.shape[1]
    imageRow = np.zeros_like(image).astype(float)
    imageCol = np.zeros_like(image).astype(float)
    for h in range(height):
        imageRow[h, :] = dct_1d(image[h, :], nc)
    for w in range(width):
        imageCol[:, w] = dct_1d(imageRow[:, w], nc)
    return imageCol
# def dct_1d(image, numberCoefficients=0):
#     nc = numberCoefficients
#     n = len(image)
#     newImage = np.zeros_like(image).astype(float)
#     for k in range(n):
#         sum = 0
#         for i in range(n):
#             sum += image[i] * cos(2 * pi * k / (2.0 * n) * i +  (k * pi) / (2.0 * n))
#         ck = sqrt(0.5) if k == 0 else 1
#         newImage[k] = sqrt(2.0 / n) * ck * sum
#     if nc > 0:
#         newImage.sort()
#         for i in range(nc, n):
#             newImage[i] = 0
#     return newImage

def dct_1d(image, numberCoefficients=0):
    nc = numberCoefficients
    n = len(image)
    newImage = np.zeros_like(image).astype(float)
    for k in range(n):
        sum = 0
        for i in range(n):
            sum += image[i] * cos(pi * (2 * i + 1) * k / (2.0 * n))
        ck = sqrt(0.5) if k == 0 else 1
        newImage[k] = sqrt(2.0 / n) * ck * sum
    if nc > 0 and nc < n:
        newImage[nc:] = 0  # Zero out coefficients after nc
    return newImage

def idct_2d(image):
    height = image.shape[0]
    width = image.shape[1]
    imageRow = np.zeros_like(image).astype(float)
    imageCol = np.zeros_like(image).astype(float)
    for h in range(height):
        imageRow[h, :] = idct_1d(image[h, :])
    for w in range(width):
        imageCol[:, w] = idct_1d(imageRow[:, w])
    return imageCol
def idct_1d(image):
    n = len(image)
    newImage = np.zeros_like(image).astype(float)
    for i in range(n):
        sum = 0
        for k in range(n):
            ck = sqrt(0.5) if k == 0 else 1
            sum += ck * image[k] * cos(2 * pi * k / (2.0 * n) *  i + (k * pi) / (2.0 * n))
        newImage[i] = sqrt(2.0 / n) * sum
    return newImage
if __name__ == '__main__':
    image=data.coffee()[::8,::8,:]/255.0
    imgResult1 = dct_2d(image, 10)
    imgResult2 = dct_2d(image, 20)
    idct_img1 = idct_2d(imgResult1)
    idct_img2 = idct_2d(imgResult2)
    plt.subplot(1,4,1)
    plt.title("Origin")
    plt.imshow(image)
    plt.subplot(1,4,2)
    plt.title("Freq Domain")
    plt.imshow(imgResult1)
    plt.subplot(1,4,3)
    plt.title("Coefficient=10")
    plt.imshow(idct_img1)
    plt.subplot(1,4,4)
    plt.title("Coefficient=20")
    plt.imshow(idct_img2)
    plt.show()
混合编码
混合编码是综合了熵编码、变换编码或预测编码的编码方法,如JPEG标准和MPEG标准。
JPEG
- 先把整个图像分解成多个8×8的图像块
- 8×8的图像块经过DCT后,低频分量都集中在左上角,高频分量则分布在右下角。
- 使用量化操作去掉高频分量,量化操作就是将某一个值除以量化表中的对应值。
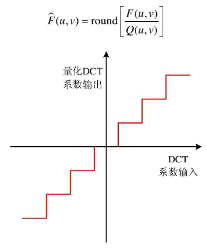
- 采用之字型(zig-zag)顺序进行行程编码(对每一个 8x8 的块进行一次zig-zag)
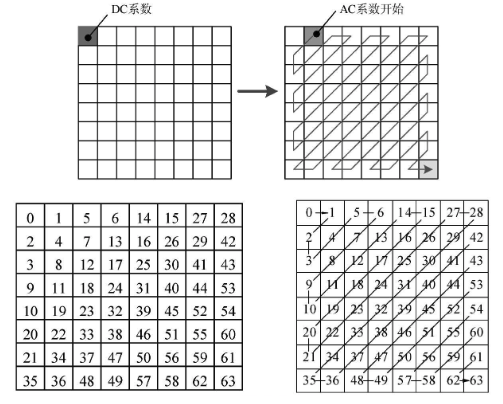
- 得到DC码字和AC行程码字后,为了进一步提高压缩比,再进行熵编码,可采用哈夫曼编码。
Reference
[1] https://en.wikipedia.org/wiki/Lempel%E2%80%93Ziv%E2%80%93Welch
[2] https://rosettacode.org/wiki/LZW_compression
[3] https://www.geeksforgeeks.org/lzw-lempel-ziv-welch-compression-technique/
[4] https://www.bilibili.com/video/BV1rp4y117WB
[5] https://www.bilibili.com/video/BV15p4y1C71G
[6] https://en.wikipedia.org/wiki/Delta_modulation
[7] https://en.wikipedia.org/wiki/Differential_pulse-code_modulation
[8] https://blog.csdn.net/gmynebula/article/details/134887145